제1원리 질문. AI 모델은 왜 하필 직선 방정식에서 출발하는가. 입력이 늘면 출력이 얼마나 느는지(w), 입력이 0일 때 기본값이 얼마인지(b)라는 두 숫자만으로 ‘관계’를 표현할 수 있고, 학습이란 결국 이 두 숫자를 데이터에 맞게 고르는 일이기 때문이다.
핵심 — 두 개의 손잡이
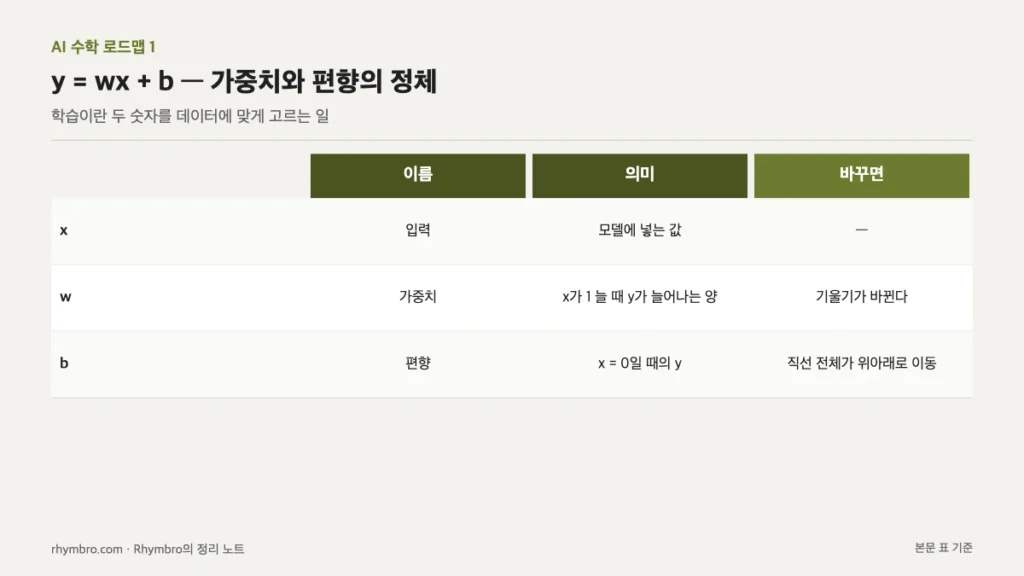
로드맵은 11주차를 “AI의 심장. 가중치 w와 편향 b의 정체”로 요약한다. 식은 y = wx + b 한 줄이다. 각 문자의 역할을 먼저 표로 고정해 둔다.
| 기호 | 이름 | 의미 | 바꾸면 |
|---|---|---|---|
| x | 입력(input) | 모델에 넣는 값 | — |
| w | 가중치(weight) | x가 1 늘 때 y가 늘어나는 양 | 직선이 가팔라지거나 완만해짐 |
| b | 편향(bias) | x = 0일 때의 y | 직선 전체가 위아래로 이동 |
| y | 출력(output) | 모델의 예측값 | — |
아래 코드의 세 조합을 그대로 그렸다. 기울기가 같은 두 직선(w=2)은 평행하고, 절편이 같은 두 직선(b=5)은 y축의 같은 점에서 출발한다.
코드로 번역하기
수식 한 줄이 코드 한 줄로 옮겨진다. NumPy 배열을 쓰면 x가 여러 개여도 반복문 없이 한 번에 계산된다.
import numpy as np

# y = w * x + b  (w: 가중치, b: 편향)
x = np.array([0, 10, 20, 30])   # 입력: 판매 잔 수 (가정 값)
w = 2.0                          # 기울기: 한 잔당 늘어나는 양
b = 5.0                          # 절편: x = 0일 때의 기본값

y = w * x + b                    # 수식 한 줄이 코드 한 줄
print("y =", y)

# w와 b를 바꾸면 직선이 어떻게 달라지는지 비교
for w_, b_ in [(2.0, 5.0), (3.0, 5.0), (2.0, 0.0)]:
    print(f"w={w_}, b={b_} ->", w_ * x + b_)
실행 결과
y = [ 5. 25. 45. 65.]
w=2.0, b=5.0 -> [ 5. 25. 45. 65.]
w=3.0, b=5.0 -> [ 5. 35. 65. 95.]
w=2.0, b=0.0 -> [ 0. 20. 40. 60.]
사례 적용 — 두 손잡이를 따로 돌려 보기
실행 결과를 보면 w를 2에서 3으로 바꿨을 때 x = 0의 값(5)은 그대로이고, x가 클수록 차이가 벌어진다(x = 30에서 65 → 95). 반대로 b를 5에서 0으로 바꾸면 모든 값이 똑같이 5씩 내려간다. w는 비율, b는 오프셋이라는 뜻이다.
이 구분은 뒤에서 배울 신경망에서도 그대로 유지된다. 신경망 한 층은 이 직선 방정식을 입력 여러 개, 출력 여러 개로 늘린 것에 가깝고, 학습 과정은 수많은 w와 b를 조금씩 조정하는 일이다. 로드맵이 16주차 미니 프로젝트를 ‘카페 매출 데이터로 1차함수 예측 모델 만들기’로 잡은 것도 이 한 줄을 데이터에 맞춰 보는 연습이다.
1분 개념 체크
로드맵 교재 템플릿의 ‘1분 개념 체크’ 형식을 빌려 스스로 확인할 문제 두 개를 만들었다.
| 질문 | 답 | 근거 |
|---|---|---|
| y = 2x + 5에서 x가 10 늘면 y는 얼마 늘어나는가? | 20 | w = 2가 ‘x 1당 y 변화량’이므로 2 × 10 |
| b만 5에서 0으로 바꾸면 그래프는 어떻게 되는가? | 기울기는 그대로, 아래로 5만큼 평행 이동 | b는 모든 x에 똑같이 더해지는 오프셋 |
내 해석 — Rhymbro가 읽은 것
w와 b는 센서 교정의 게인(gain)과 오프셋(offset)과 같은 구조로 읽혔다. 로드셀이나 변위 센서의 출력 전압을 물리량으로 바꿀 때도 ‘기울기 × 입력 + 영점’ 형태의 1차식을 쓴다. 교정은 두 숫자를 기준값에 맞추는 일이고, AI의 학습도 두 숫자를 데이터에 맞추는 일이라는 점에서 같은 문제를 다른 이름으로 부르는 것 같았다.
다만 현실의 관계가 직선이 아닐 때는 이 식 하나로는 부족하다. 로드맵이 바로 다음 12주차에 이차함수를 두고 ‘손실함수 형태의 예고편’이라고 적어 둔 이유가 여기 있다고 본다.
한계로, 실제 데이터는 잡음이 있어 모든 점을 지나는 직선이 존재하지 않으므로, ‘가장 덜 틀리는’ w와 b를 고르는 기준(손실함수)이 따로 필요하다.
요약
| 항목 | 정리 |
|---|---|
| 식 | y = wx + b |
| w (가중치) | 기울기, 입력 1당 출력 변화량 |
| b (편향) | x = 0일 때 값, 전체 평행 이동 |
| 코드 | y = w * x + b (NumPy 배열 그대로) |
그래서 나는 무엇을 하기로 했나
이번 주는 w와 b를 슬라이더처럼 바꿔 가며 직선을 다시 그려 보고, 각 조합에서 x = 0과 x = 30의 값을 표로 적어 두기로 했다.
주제와 순서는 개인 학습용으로 정리한 104주 AI 수학 로드맵 목차를 따랐고, 설명과 예제는 그 목차를 바탕으로 내 언어로 다시 썼다. 코드는 Python 3 + NumPy 2.x에서 실행해 출력을 확인했으며, 예시 수치는 설명용 가정 값이다.
AI 수학 로드맵 노트 · 전체 10편
- AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체
- AI 수학 로드맵 노트 2 — 지수와 로그, 폭발과 압축의 언어
- AI 수학 로드맵 노트 3 — Σ(시그마)는 그냥 for문이다
- AI 수학 로드맵 노트 4 — 벡터의 크기와 거리, 노름
- AI 수학 로드맵 노트 5 — 내적과 코사인 유사도, 방향이 비슷하면 취향도 비슷하다
- AI 수학 로드맵 노트 6 — 행렬곱, 신경망 한 층의 정체
- AI 수학 로드맵 노트 7 — 미분과 체인룰, 변화가 전달되는 법
- AI 수학 로드맵 노트 8 — 경사하강법과 학습률, 산을 내려가는 보폭
- AI 수학 로드맵 노트 9 — 손실함수 MSE, 얼마나 틀렸나를 숫자 하나로
- AI 수학 로드맵 노트 10 — 베이즈 정리, 검사 결과를 뒤집어 읽기
같은 카테고리에서 함께 읽기
강의자료 121편
독일어 문법 노트 10 — 관계절, Die Maschine, die wir kauften
관계대명사의 성·수는 선행사를 따르고, 격은 관계절 안에서의 역할로 정해진다. 전치사 + 관계대명사, wo와 was·wer까지 설비·부품 예문으로 정리했다.
독일어 문법 노트 9 — 종속절과 동사 후치, weil·dass·wenn·als
weil·dass·wenn·obwohl·ob가 이끄는 절에서는 활용된 동사가 맨 끝으로 간다. 종속절이 앞에 오면 쉼표를 사이에 두고 동사가 마주 보는 구조, als…
독일어 문법 노트 8 — 형용사 어미변화, 다섯 칸의 -e와 나머지 -en
정관사가 성·격을 표시하면 형용사는 -e나 -en만 붙는다. -e가 오는 자리는 다섯 칸뿐이고 나머지는 전부 -en. 서술 용법에는 어미가 없다는 점까지 정리했다.
[…] AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체 […]
[…] AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체 […]
[…] AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체 […]
[…] AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체 […]
[…] AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체 […]
[…] AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체 […]