제1원리 질문. AI는 정답 가중치를 한 번에 계산하지 않고 왜 조금씩 고쳐 가는가. 모델이 복잡하면 오차를 0으로 만드는 가중치를 식으로 바로 풀 수 없는 경우가 대부분이라, 현재 위치의 기울기만 보고 ‘내려가는 방향’으로 조금씩 이동하는 방법이 가장 현실적이기 때문이다.
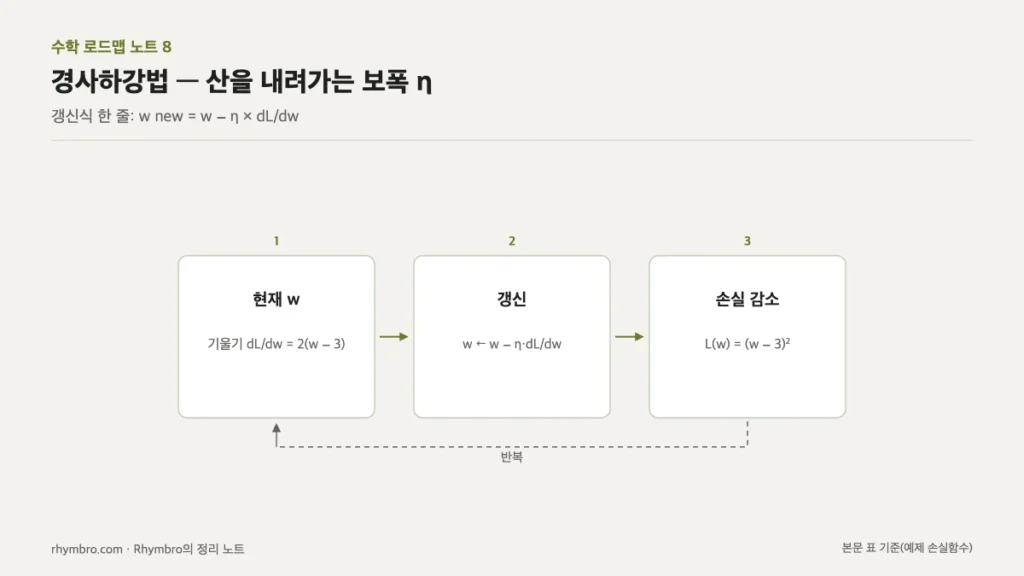
핵심 — 갱신식 한 줄
로드맵은 43주차를 “조금씩 반대 방향으로, 학습의 정체”, 44주차를 “보폭 조절과 골짜기(local minima) 이야기”로 요약한다. 경사하강법(gradient descent)의 갱신식은 한 줄이다.
| 기호 | 이름 | 역할 |
|---|---|---|
| wnew = w − η × dL/dw | 갱신식 | 현재 w에서 기울기 반대로 이동 |
| L(w) | 손실함수 | 얼마나 틀렸나 (여기서는 (w − 3)2) |
| dL/dw | 기울기 | 2(w − 3), 오르막 방향 |
| η | 학습률(learning rate) | 한 번에 내딛는 보폭 |
골짜기 바닥(w = 3)에 가까워질수록 기울기가 작아져 보폭도 자동으로 줄어든다.
코드로 번역하기
같은 시작점(w = 0)에서 학습률만 0.1, 0.9, 1.1로 바꿔 다섯 걸음씩 이동시킨다.
# 손실 L(w) = (w - 3)^2, 최솟값은 w = 3
def grad(w):
    return 2 * (w - 3)             # dL/dw

for lr in [0.1, 0.9, 1.1]:         # 학습률(보폭) 세 가지 비교
    w = 0.0                        # 시작점
    hist = []
    for step in range(5):
        w = w - lr * grad(w)       # 경사하강법 갱신식
        hist.append(round(w, 3))
    print(f"lr={lr}:", hist)
실행 결과
lr=0.1: [0.6, 1.08, 1.464, 1.771, 2.017]
lr=0.9: [5.4, 1.08, 4.536, 1.771, 3.983]
lr=1.1: [6.6, -1.32, 8.184, -3.221, 10.465]
사례 적용 — 보폭이 결과를 가른다
| 학습률 | 5걸음 뒤 w | 움직임 |
|---|---|---|
| 0.1 | 2.017 | 한쪽에서 차분히 다가감 |
| 0.9 | 3.983 | 바닥(3)을 넘나들며 좌우로 튕김 |
| 1.1 | 10.465 | 튕길 때마다 더 멀어짐 (발산) |
표가 44주차 ‘보폭 조절’의 의미를 보여 준다. 0.1은 느리지만 안정적이다. 0.9는 바닥을 계속 넘어가며 진동하고, 1.1은 넘어갈 때마다 더 멀리 튕겨서 오차가 오히려 커진다. 학습률은 코드 한 글자지만 학습의 성패를 좌우하는 설정값이다.
이번 예제의 손실은 바닥이 하나뿐인 단순한 골짜기다. 실제 손실 지형에는 작은 웅덩이(local minima)가 여러 개 있을 수 있어서, 경사하강법이 가장 깊은 바닥이 아닌 곳에 멈출 수도 있다는 점이 44주차의 두 번째 이야기다.
1분 개념 체크
로드맵 교재 템플릿의 ‘1분 개념 체크’ 형식을 빌려 스스로 확인할 문제 두 개를 만들었다.
| 질문 | 답 | 근거 |
|---|---|---|
| L = (w − 3)2, w = 5, 학습률 0.1이면 다음 w는? | 4.6 | 기울기 2(5 − 3) = 4, 5 − 0.1 × 4 |
| 학습률 1.1에서 w가 발산한 이유는? | 한 걸음이 바닥을 너무 멀리 넘어감 | 넘을 때마다 바닥과의 거리가 커짐 |
내 해석 — Rhymbro가 읽은 것
학습률의 세 결과는 피드백 제어의 게인 튜닝과 같은 모양이었다. 게인이 작으면 목표값에 느리게 수렴하고, 크면 오버슈트로 진동하며, 더 크면 발산한다. 장력 제어나 위치 제어에서 게인을 올리다 진동이 시작되는 지점을 찾는 튜닝 과정이 학습률 선택과 구조적으로 같다고 느꼈다.
그래서 학습률도 ‘정답 값’이 있다기보다 문제마다 튜닝하는 값이라고 받아들였다. 로드맵 2년 차 75~84주차의 최적화 심화에서 이 튜닝을 자동으로 돕는 방법들이 나오는 것으로 되어 있다.
한계로, 이 예제는 가중치가 하나뿐이라 그래프로 볼 수 있지만, 실제 모델은 가중치가 수백만 개라 손실 지형을 직접 볼 수 없고 학습률도 실험으로 정해야 한다.
요약
| 항목 | 정리 |
|---|---|
| 갱신식 | w ← w − η × dL/dw |
| 방향 | 기울기의 반대 = 내리막 |
| 학습률 작음 | 느리지만 안정 |
| 학습률 큼 | 진동 또는 발산 |
그래서 나는 무엇을 하기로 했나
이번 주는 같은 코드에서 학습률을 0.01부터 1.2까지 여러 값으로 바꿔 20걸음 뒤의 w를 표로 만들고, 진동이 시작되는 경계를 직접 찾아보기로 했다.
주제와 순서는 개인 학습용으로 정리한 104주 AI 수학 로드맵 목차를 따랐고, 설명과 예제는 그 목차를 바탕으로 내 언어로 다시 썼다. 코드는 Python 3 + NumPy 2.x에서 실행해 출력을 확인했으며, 예시 수치는 설명용 가정 값이다.
AI 수학 로드맵 노트 · 전체 10편
- AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체
- AI 수학 로드맵 노트 2 — 지수와 로그, 폭발과 압축의 언어
- AI 수학 로드맵 노트 3 — Σ(시그마)는 그냥 for문이다
- AI 수학 로드맵 노트 4 — 벡터의 크기와 거리, 노름
- AI 수학 로드맵 노트 5 — 내적과 코사인 유사도, 방향이 비슷하면 취향도 비슷하다
- AI 수학 로드맵 노트 6 — 행렬곱, 신경망 한 층의 정체
- AI 수학 로드맵 노트 7 — 미분과 체인룰, 변화가 전달되는 법
- AI 수학 로드맵 노트 8 — 경사하강법과 학습률, 산을 내려가는 보폭
- AI 수학 로드맵 노트 9 — 손실함수 MSE, 얼마나 틀렸나를 숫자 하나로
- AI 수학 로드맵 노트 10 — 베이즈 정리, 검사 결과를 뒤집어 읽기
같은 카테고리에서 함께 읽기
강의자료 121편
독일어 문법 노트 10 — 관계절, Die Maschine, die wir kauften
관계대명사의 성·수는 선행사를 따르고, 격은 관계절 안에서의 역할로 정해진다. 전치사 + 관계대명사, wo와 was·wer까지 설비·부품 예문으로 정리했다.
독일어 문법 노트 9 — 종속절과 동사 후치, weil·dass·wenn·als
weil·dass·wenn·obwohl·ob가 이끄는 절에서는 활용된 동사가 맨 끝으로 간다. 종속절이 앞에 오면 쉼표를 사이에 두고 동사가 마주 보는 구조, als…
독일어 문법 노트 8 — 형용사 어미변화, 다섯 칸의 -e와 나머지 -en
정관사가 성·격을 표시하면 형용사는 -e나 -en만 붙는다. -e가 오는 자리는 다섯 칸뿐이고 나머지는 전부 -en. 서술 용법에는 어미가 없다는 점까지 정리했다.
[…] AI 수학 로드맵 노트 8 — 경사하강법과 학습률, 산을 내려가는 보폭 […]
[…] AI 수학 로드맵 노트 8 — 경사하강법과 학습률, 산을 내려가는 보폭 […]
[…] AI 수학 로드맵 노트 8 — 경사하강법과 학습률, 산을 내려가는 보폭 […]