제1원리 질문. 민감도 99% 검사에서 양성이 나왔는데 왜 실제로 병이 있을 확률은 훨씬 낮을 수 있는가. 우리가 아는 것은 ‘병이 있을 때 양성이 나올 확률’인데 궁금한 것은 ‘양성일 때 병이 있을 확률’이라 조건의 방향이 반대이고, 이 방향을 뒤집으려면 원래 얼마나 흔한 병인지(사전확률)를 반드시 넣어야 하기 때문이다.
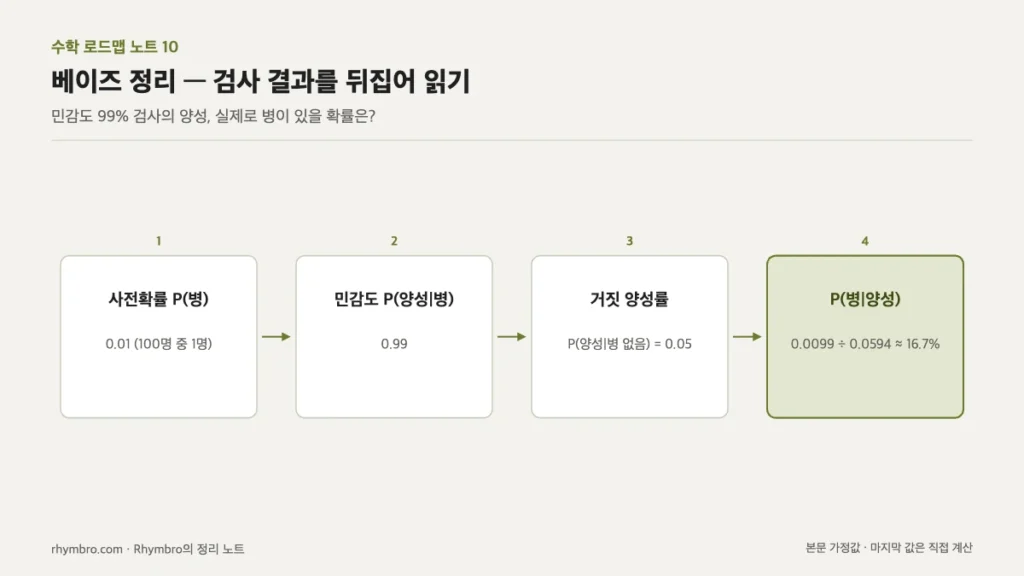
핵심 — 조건의 방향 뒤집기
로드맵은 51주차 조건부 확률을 “정보가 들어오면 확률이 바뀐다”, 53주차 베이즈 정리를 “믿음의 업데이트 — 검사 결과 뒤집어 읽기”로 요약한다. 식은 P(병 | 양성) = P(양성 | 병) × P(병) / P(양성)이다.
| 기호 | 이름 | 이번 예의 값 (가정) |
|---|---|---|
| P(병) | 사전확률(prior) | 0.01 (100명 중 1명) |
| P(양성 | 병) | 민감도 | 0.99 |
| P(양성 | 병 없음) | 거짓 양성률 | 0.05 |
| P(병 | 양성) | 사후확률(posterior) | 계산 결과 약 0.1667 |
확률 식보다 사람 수로 세면 직관이 빨리 잡힌다. 양성 594명 중 대부분(495명)이 거짓 양성이다.
코드로 번역하기
식 그대로 계산한 값과 1만 명으로 센 값이 같은지 함께 확인한다. 세 입력값은 모두 설명용 가정 값이다.
# 베이즈 정리: P(병|양성) = P(양성|병) * P(병) / P(양성)
p_d   = 0.01    # 사전확률: 유병률 1% (가정 값)
sens  = 0.99    # 병이 있을 때 양성 확률 (가정 값)
fpr   = 0.05    # 병이 없는데 양성 확률 (가정 값)

p_pos = sens * p_d + fpr * (1 - p_d)       # 전체 양성 확률
post  = sens * p_d / p_pos                 # 사후확률
print(round(p_pos, 4))                     # 0.0594
print(round(post, 4))                      # 0.1667

# 1만 명으로 세어 보기
N = 10_000
sick_pos = N * p_d * sens                  # 99명
well_pos = N * (1 - p_d) * fpr             # 495명
print(sick_pos, well_pos, round(sick_pos / (sick_pos + well_pos), 4))
실행 결과
0.0594
0.1667
99.0 495.0 0.1667
사례 적용 — 사전확률이 결과를 지배한다
민감도가 99%여도 사후확률이 약 17%에 그친 이유는 병이 드물기 때문이다. 병이 없는 사람이 워낙 많아서, 그중 5%만 잘못 양성이 나와도 진짜 양성보다 수가 많아진다. 같은 검사를 한 번 더 해서 또 양성이 나오면, 이번 사후확률 0.1667이 다음 계산의 사전확률이 된다. 이것이 ‘믿음의 업데이트’라는 표현의 뜻이다.
로드맵 54주차는 이 구조를 스팸 필터로 옮긴다. ‘스팸일 사전확률’에서 출발해 메일 속 단어 하나하나를 증거로 삼아 확률을 계속 업데이트하는 방식이고, 64주차 미니 프로젝트가 이를 직접 구현하는 ‘나이브 베이즈 스팸 분류기’다. 2편에서 본 ‘곱셈을 로그의 덧셈으로’ 바꾸는 성질이 이 계산에서 다시 쓰인다.
1분 개념 체크
로드맵 교재 템플릿의 ‘1분 개념 체크’ 형식을 빌려 스스로 확인할 문제 두 개를 만들었다.
| 질문 | 답 | 근거 |
|---|---|---|
| 이번 예에서 1만 명 중 양성 판정은 모두 몇 명인가? | 594명 | 99 + 495 |
| 양성이 다시 나올 때 다음 계산의 사전확률은? | 약 0.1667 | 이번 사후확률이 새 사전확률 |
내 해석 — Rhymbro가 읽은 것
베이즈 정리를 보며 설비 알람 해석이 떠올랐다. 이상 감지 알람의 감지율이 높아도 실제 고장이 드문 설비라면, 울린 알람 대부분이 오경보일 수 있다. 알람 하나만 보고 판단하기보다 ‘원래 이 고장이 얼마나 드문가’를 함께 넣어야 한다는 점에서, 베이즈 정리는 현장 판단의 순서를 수식으로 적은 것처럼 읽혔다.
또 입력값 셋 중 하나만 바꿔도 결과가 크게 달라진다는 점이 인상적이었다. 유병률을 1%에서 10%로 바꾸면 결과가 어떻게 되는지는 직접 계산해 볼 과제로 남겨 둔다.
한계로, 사전확률 값 자체를 정확히 알기 어려운 경우가 많아서, 베이즈 계산의 결과는 입력한 사전확률의 신뢰도를 넘을 수 없다.
요약
| 항목 | 정리 |
|---|---|
| 식 | P(A | B) = P(B | A) P(A) / P(B) |
| 핵심 | 조건의 방향을 뒤집을 때 사전확률이 필요 |
| 이번 예 | 민감도 99%, 거짓 양성률 5%, 유병률 1% → 양성 시 약 16.7% |
| 업데이트 | 이번 사후확률 = 다음 사전확률 |
그래서 나는 무엇을 하기로 했나
이번 주는 같은 코드에서 유병률을 0.1%, 1%, 10%로 바꿔 사후확률 표를 만들고, 검사를 두 번 연속 양성으로 받았을 때의 값도 계산해 보기로 했다.
주제와 순서는 개인 학습용으로 정리한 104주 AI 수학 로드맵 목차를 따랐고, 설명과 예제는 그 목차를 바탕으로 내 언어로 다시 썼다. 코드는 Python 3 + NumPy 2.x에서 실행해 출력을 확인했으며, 예시 수치는 설명용 가정 값이다.
AI 수학 로드맵 노트 · 전체 10편
- AI 수학 로드맵 노트 1 — y = wx + b, 가중치와 편향의 정체
- AI 수학 로드맵 노트 2 — 지수와 로그, 폭발과 압축의 언어
- AI 수학 로드맵 노트 3 — Σ(시그마)는 그냥 for문이다
- AI 수학 로드맵 노트 4 — 벡터의 크기와 거리, 노름
- AI 수학 로드맵 노트 5 — 내적과 코사인 유사도, 방향이 비슷하면 취향도 비슷하다
- AI 수학 로드맵 노트 6 — 행렬곱, 신경망 한 층의 정체
- AI 수학 로드맵 노트 7 — 미분과 체인룰, 변화가 전달되는 법
- AI 수학 로드맵 노트 8 — 경사하강법과 학습률, 산을 내려가는 보폭
- AI 수학 로드맵 노트 9 — 손실함수 MSE, 얼마나 틀렸나를 숫자 하나로
- AI 수학 로드맵 노트 10 — 베이즈 정리, 검사 결과를 뒤집어 읽기
같은 카테고리에서 함께 읽기
강의자료 121편
독일어 문법 노트 10 — 관계절, Die Maschine, die wir kauften
관계대명사의 성·수는 선행사를 따르고, 격은 관계절 안에서의 역할로 정해진다. 전치사 + 관계대명사, wo와 was·wer까지 설비·부품 예문으로 정리했다.
독일어 문법 노트 9 — 종속절과 동사 후치, weil·dass·wenn·als
weil·dass·wenn·obwohl·ob가 이끄는 절에서는 활용된 동사가 맨 끝으로 간다. 종속절이 앞에 오면 쉼표를 사이에 두고 동사가 마주 보는 구조, als…
독일어 문법 노트 8 — 형용사 어미변화, 다섯 칸의 -e와 나머지 -en
정관사가 성·격을 표시하면 형용사는 -e나 -en만 붙는다. -e가 오는 자리는 다섯 칸뿐이고 나머지는 전부 -en. 서술 용법에는 어미가 없다는 점까지 정리했다.
[…] AI 수학 로드맵 노트 10 — 베이즈 정리, 검사 결과를 뒤집어 읽기 […]